

生成式人工智能(Generative Artificial Intelligence,GenAI)的快速发展,正在改变高等教育中的知识获取、问题解决与学习评价方式。尤其是在科学、技术、工程与数学(STEM)教育领域,生成式人工智能已经能够针对许多标准化分析问题和算法问题生成结构化解答。这也使传统考试面临一个新的问题:当学生能够借助AI完成原本需要独立思考的任务,考试成绩还能在多大程度上反映学生真实的知识掌握与思维能力?
2026年10月26日,Dizza Beimel等学者在国际期刊《Education and Information Technologies》发表研究论文《Rethinking student examinations in STEM education in the age of generative AI: evidence from a controlled experiment》。研究通过一项涉及95名STEM专业本科生的被试内实验,比较学生在有无生成式人工智能辅助情况下的考试表现,同时分析学生验证AI答案的程度及其具体使用方式。
研究不仅发现,允许使用生成式人工智能时,学生的考试成绩整体显著提高,而且进一步揭示了不同初始成绩学生的表现差异,以及完全验证AI生成答案与成绩提升之间的显著关联。这项研究将讨论从AI是否应该进入考试,推进到AI辅助条件下究竟应该评价学生什么能力。
01
研究背景
AI辅助解题
正在挑战传统考试的评价效度
传统STEM考试通常通过知识回忆、程序性问题解决和标准化任务,评价学生对学科知识的掌握程度与应用能力。然而,生成式人工智能能够快速提供问题解释、算法步骤和解决方案,使过去需要学生独立完成的部分认知任务可以由AI直接辅助完成。由此,考试最终呈现的答案是否真正反映学生自身的理解与推理,成为评价效度面临的新问题。
与此同时,生成式人工智能并非始终可靠。它可能生成看似合理、实际上存在事实或逻辑错误的内容,即所谓的AI幻觉。对于学科知识尚未充分发展的本科生而言,识别这些隐蔽错误并不容易。如果学生缺乏必要的验证意识,直接接受AI提供的答案,反而可能形成错误的知识理解与问题解决方式。
作者指出,既有研究已经广泛讨论生成式人工智能在教学和学习中的应用,但对于其在真实考试情境中的作用,尤其是考试成绩、学生验证行为和具体使用方式之间的关系,仍缺乏充分的实证证据。
为此,研究引入认知负荷理论(Cognitive Load Theory,CLT)作为解释框架。该理论强调,学习者的工作记忆容量有限,认知负荷过高会影响知识图式的建构。生成式人工智能可能通过提供即时解释和解决方案,减少学习者处理复杂任务时的外在认知负荷;但与此同时,学生还需要判断AI答案是否准确、是否符合学科知识,这又会产生额外的监控与评价负担。
因此,AI辅助考试的效果可能并不只取决于工具本身,还与学生的知识基础以及对AI输出的处理方式密切相关。
02
研究设计
通过两次真实课堂考试
考察AI的作用
本研究采用被试内实验设计(within-subjects experimental design),将客观考试成绩与考后问卷数据结合起来,重点回答三个问题:使用生成式人工智能是否会改变学生的考试表现?学生验证AI生成答案的程度是否与成绩变化有关?学生在考试中主要出于什么目的使用生成式人工智能?
研究对象来自同一所高校的两门本科课程,分别为计算机科学专业的《数据结构》课程,以及工程与管理专业信息系统与数据科学方向的《数据结构与算法》课程。两门课程均由同一位教师授课,涉及算法思维、数据结构及相关问题解决任务。最初共有141名学生参与,最终有95名学生完成两次考试,构成成绩比较的核心样本。其中,计算机科学专业49人,工程与管理专业46人。
实验分两个连续教学周进行。第11周,学生参加不允许使用生成式人工智能的课堂考试,但可以携带一张笔记;第12周,学生在计算机实验室参加允许使用生成式人工智能的在线考试。两次考试均安排约30分钟,覆盖各自课程前一阶段所学内容,并在学习目标、题目难度结构和考核要求方面进行匹配。
两次考试均包含6道题,其中前5题为选择题,第6题为开放性问题;题目难度分别设置为2道简单题、2道中等难度题和2道困难题。研究者根据课程教学目标和以往学生表现确定题目难度,并考虑到第二次考试允许使用AI,将分析性问题的复杂程度进行调整,以考查学生较高层次的思维能力,而不是简单检索常规解法。
在第二次考试中,学生可以自由选择ChatGPT、Copilot、Gemini等人工智能工具,研究没有对AI使用方式作出具体指导或限制,也没有要求学生采用统一的提示词策略,以尽可能保留自然考试情境中的使用行为。考试结束后,学生填写问卷,报告使用AI的目的以及验证AI生成答案的程度。
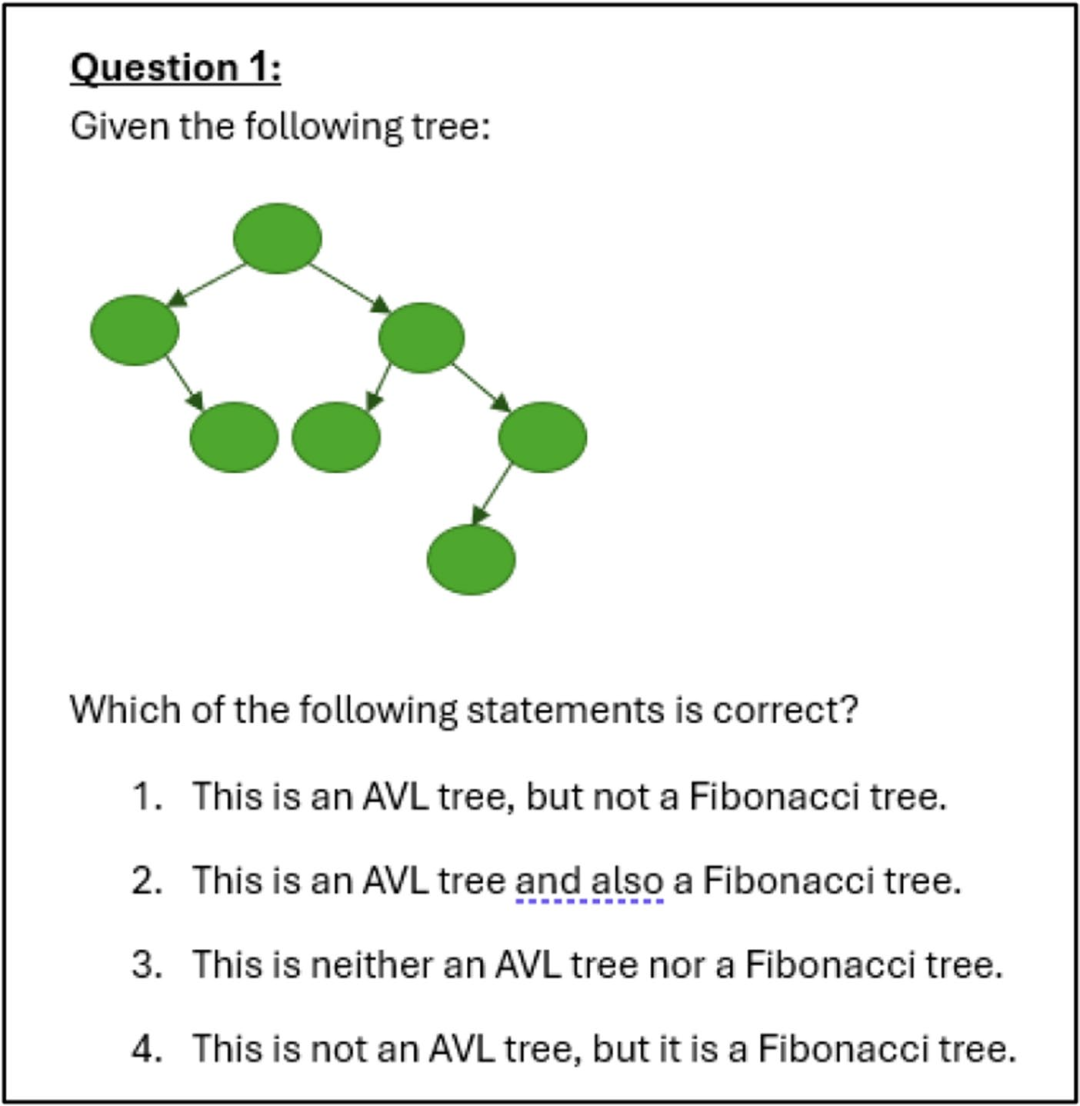
Fig.1 第11周计算机科学考试中的一道AVL树与斐波那契树
研究工具主要包括两部分:一是两次考试的客观成绩,用于比较学生在不同考试条件下的表现;二是考后问卷,用于分析学生使用AI的行为。问卷将使用目的划分为理解题目、搜索解题方案、验证自己的答案三类;将验证程度划分为未验证、部分验证和完全验证三类。
在数据分析方面,研究首先采用配对样本检验比较同一学生两次考试的成绩变化;随后依据学生的初始成绩水平考察不同群体的表现差异,并通过分层回归分析,在控制初始成绩后检验验证行为与成绩提升之间的关系。最终,不同研究问题分别采用不同的有效样本:成绩比较为95人,验证行为分析为85人,AI使用目的分析为92人。
03
研究发现
AI辅助考试提升了成绩,
但不同学生的变化并不相同
1. AI辅助条件下考试成绩整体显著提高
研究发现,学生在允许使用生成式人工智能的第二次考试中取得了更高成绩。95名学生的平均分从无AI条件下的54.70分提高至有AI条件下的69.91分,平均增加15.21分,差异达到统计显著水平(p<0.001),效应量为中等偏大水平(Cohen's d=0.525)。
不过,成绩提升并非在所有学生中均匀发生。研究根据第一次考试成绩,将学生划分为低、中、高三个初始表现组。结果显示,低成绩组平均提升45.88分,中等成绩组提升19.66分,而高成绩组平均变化为下降10.26分。三组之间的提升幅度差异具有统计显著性。
采用学期末考试成绩进行另一种分组后,研究也观察到相似趋势:低成绩组提升28.47分,中等成绩组提升15.84分,高成绩组提升7.76分。整体而言,初始表现较低的学生观察到更大的成绩增幅,而高成绩学生的变化相对有限。
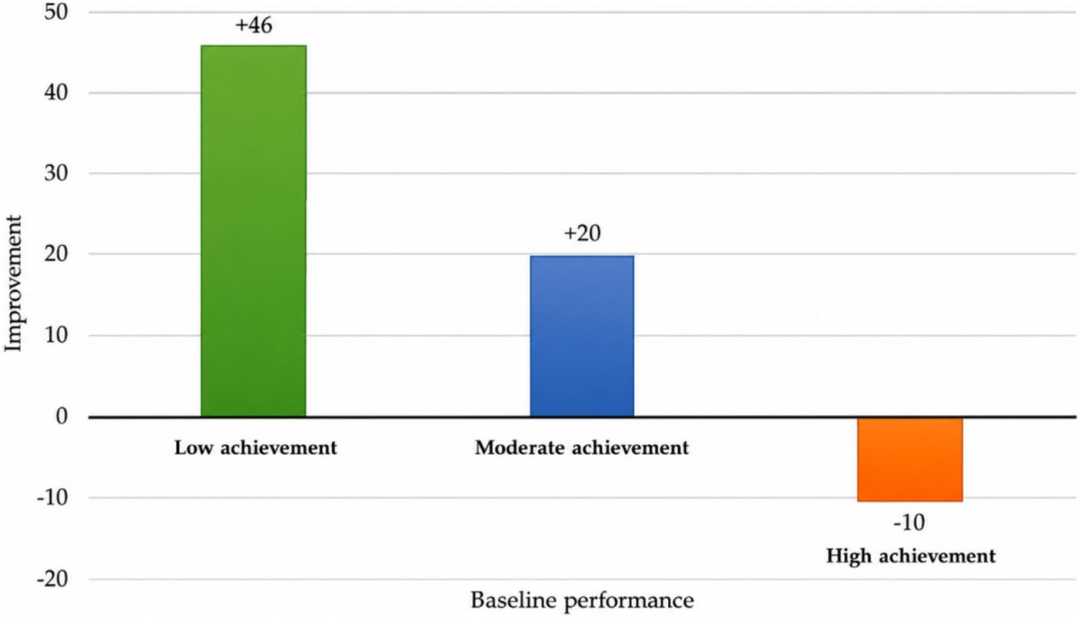
Fig.2 低、中、高初始成绩组在使用GenAI后的成绩变化
从题目难度来看,AI辅助条件下,中等难度题的正确率提升幅度最大,为27.1%;简单题为23.4%;困难题为14.9%。这表明,成绩变化并不只是体现在某一类题目上,但不同难度任务所呈现的提升程度存在差异。
需要注意的是,作者对这一结果作出了谨慎说明。由于初始成绩既用于划分学生群体,也参与计算成绩变化,结果可能受到数学耦合和向均值回归的影响;此外,低成绩学生有更大的提升空间,而高成绩学生可能受到天花板效应限制。因此,不能直接据此认定生成式人工智能必然对低成绩学生产生了更大的教育收益。
2. 完全验证AI答案与更大的成绩提升显著相关
研究的第二个重要发现,是学生对AI输出的验证程度与考试成绩变化之间存在关联。
在完成相关问卷的85名学生中,56.5%的学生表示验证了AI提供的全部答案,41.2%的学生只验证了部分答案,另有2.4%的学生表示没有验证任何答案。由于未验证组只有2人,样本量不足以开展有意义的组间比较,因此后续分析主要比较完全验证组和部分验证组。
从未经调整的平均成绩变化来看,完全验证组平均提高20.31分,部分验证组提高8.20分。但两组差异尚未达到统计显著水平(p=0.067)。
随后,研究采用分层回归分析控制学生的初始成绩。结果显示,在考虑初始成绩后,完全验证组的成绩提升幅度比部分验证组高11.33分,且这一关联达到统计显著水平(B=11.33,p=0.006)。验证行为额外解释了3.5%的成绩变化差异。
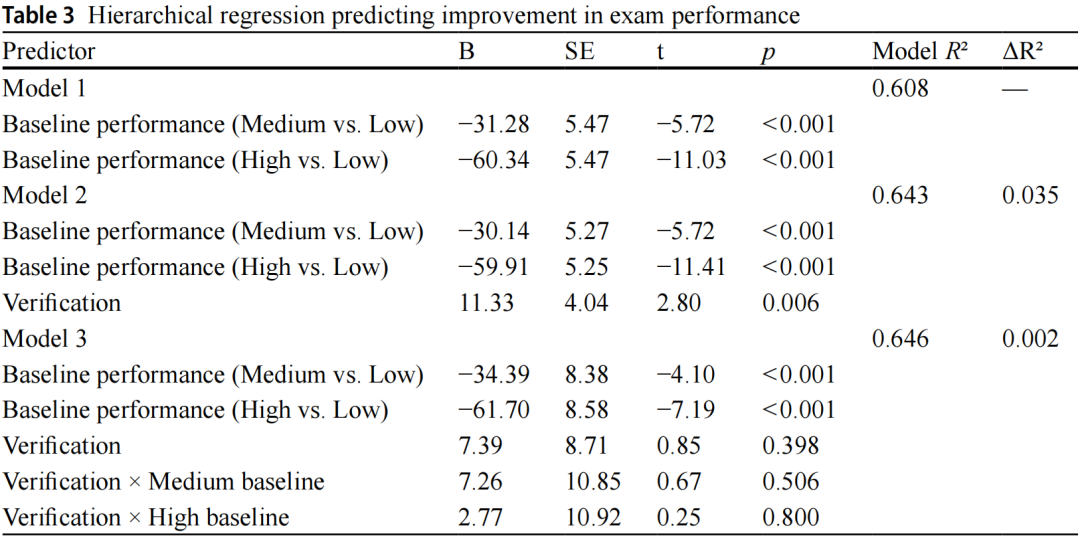
Table.3 预测考试成绩改善的分层回归分析
这一结果意味着,学生是否主动检查和判断生成式人工智能提供的答案,可能是影响AI辅助考试表现的重要因素。需要强调的是,研究证明的是控制初始成绩后的统计关联,而不是完全验证行为必然导致成绩提高。
3. 学生主要将AI用于寻找解法和检查答案
在AI使用目的方面,研究发现学生主要将生成式人工智能作为面向任务的解题和核验工具,而不是用于深入理解概念。
具体而言,70.7%的学生使用AI搜索解题方案,70.7%的学生使用AI检查自己已有答****性,56.5%的学生使用AI辅助理解考试题目。由于问卷允许多选,因此各项比例之和超过100%。
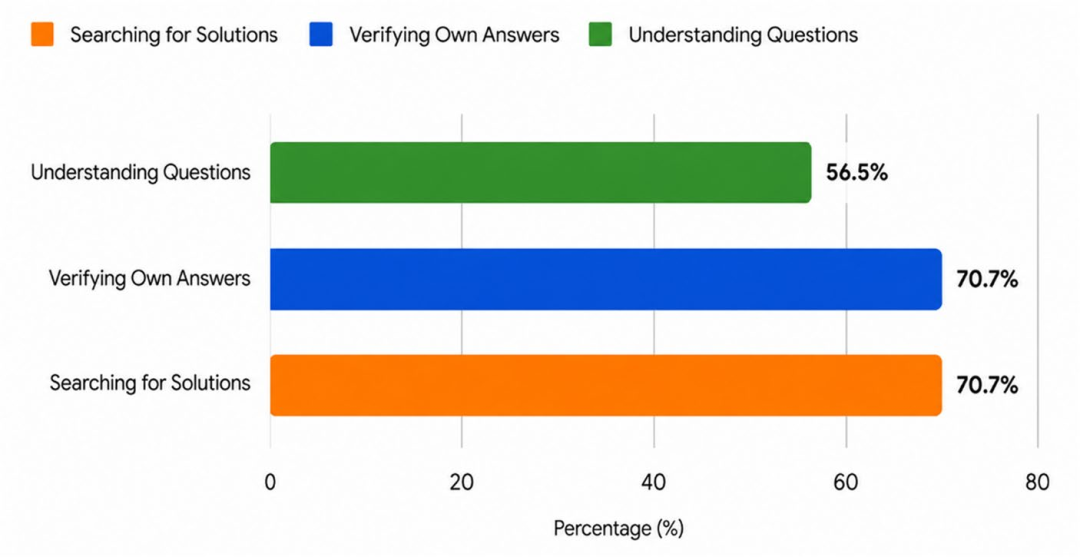
Fig.4 考试期间使用生成式人工智能的主要目的
由此可以看出,学生在短时考试中更多关注如何获得解决方案,以及如何确认已有答案是否正确。作者将这一使用特征概括为面向任务和结果的工具性使用。值得注意的是,这里的验证包含两个方向:学生既会借助AI检查自己的答案,也需要判断AI生成的答案是否可靠。
这提示我们,AI辅助考试中的验证并不是单纯的技术操作,而是涉及学生对答案质量、准确性及其与学科知识之间一致性的判断。
04
研究结论
考试评价需要从答案
转向思维过程
综合三个研究问题,作者认为,生成式人工智能进入STEM考试后,学生的短期考试表现出现了显著变化,但这种变化受到学生初始表现水平和验证行为等因素的影响。
在理论解释上,研究尝试借助认知负荷理论中的专长反转效应(expertise reversal effect)理解不同成绩群体的表现差异。该效应指出,同一种认知支持可能对知识基础较弱的学习者有帮助,却未必适合知识基础较强的学习者。
作者推测,对于初始表现较低的学生,生成式人工智能提供的即时解答可能减少其独立组织知识的负担,降低外在认知负荷,使其能够将更多认知资源用于理解和处理问题。对于表现较好的学生,已有知识基础可能使其能够独立形成解题路径,而额外检查AI输出则可能增加比较、判断和验证的时间与认知成本。
但作者明确指出,这一解释属于具有理论合理性的推测,并非本研究直接检验的认知机制。研究还发现,完全验证与成绩提升之间存在显著关联,但验证行为对成绩变化的额外解释作用相对有限,仍需结合其他因素理解。
在实践层面,作者提出了一个重要转向:考试不应继续仅仅评价学生知道什么,而应更多评价学生在生成式人工智能辅助下如何思考。原文强调,考试应从知识回忆转向对学生“批判性综合、论证与验证”能力的评价。
CONCLUSION
结语
生成式人工智能正在改变STEM学习任务的完成方式,也促使教育研究者重新审视考试所要测量的能力。这项研究通过真实课堂考试提供了初步实证证据:AI辅助条件下学生成绩整体提高,但成绩变化存在群体差异;完全验证AI答案与更大的成绩提升相关;学生实际使用AI时,则主要关注解题和答案核验。
当然,研究仅涉及同一高校的两门本科课程,考试持续时间较短,且两次考试按照固定顺序实施,考试内容也有所不同。因此,当前结果主要反映短期考试表现,不能直接推断学生长期知识掌握、技能迁移或独立解决问题能力的变化。
对于科学教育研究者而言,这项研究的重要价值不只是说明AI能够帮助学生获得更高的考试分数,而是提示我们进一步思考:当人工智能成为学生解决问题的常用工具,科学教育评价应如何同时关注学科知识、证据推理、批判性判断以及对技术输出的负责任使用?
未来的考试设计,或许需要从单纯检验学生能否给出正确答案,逐步转向考察学生能否理解答案、审查证据、发现错误并为自己的判断提供合理解释。这也正是生成式人工智能时代,STEM教育评价需要回应的重要课题。