导读
当ChatGPT们能轻松写出结构完整的实验报告、代码作业和论述题答案,STEM教育中核心的一环——评价,正面临前所未有的挑战。学生提交的作业,还能证明他真正理解了吗?
2026年,Milo D. Koretsky等学者在《International Journal of STEM Education》发表文章,以“评价三角”为框架,从生态系统视角系统梳理了生成式AI对STEM教育评价的冲击与重构。文章提出三个关键主题:AI已深度“纠缠”于评价系统、AI正被用于分析与反馈、AI生成的教学材料亟需效度验证。这对一线教师、课程设计者和教育管理者都具有重要参考价值。
01
在STEM教育中,有一个长期存在的现实:评价驱动学习。学生怎么学、学什么,很大程度上取决于怎么考。
但生成式AI正在动摇这一基础。文章开篇举了一个真实案例:2026年春季,布朗大学一位教授发现,一次带回家完成的中期考试,77名学生平均分高达96%,许多答案的推理方式与ChatGPT高度相似。当他改用在考场内完成的期末考试后,18名学生退课,平均分跌至50%以下,19人不及格。
这个案例说明:传统评价方式在AI面前,正在失去区分“学生自己会”和“AI会”的能力。
更值得警惕的是,这不仅是“作弊”问题。文章主张,应把它看作效度问题——即评价是否还能提供关于学生学习的可信证据。如果AI完成了大部分关键智力工作,那么提交的作业就无法支撑“学生已掌握目标能力”的推断。
02
理论框架
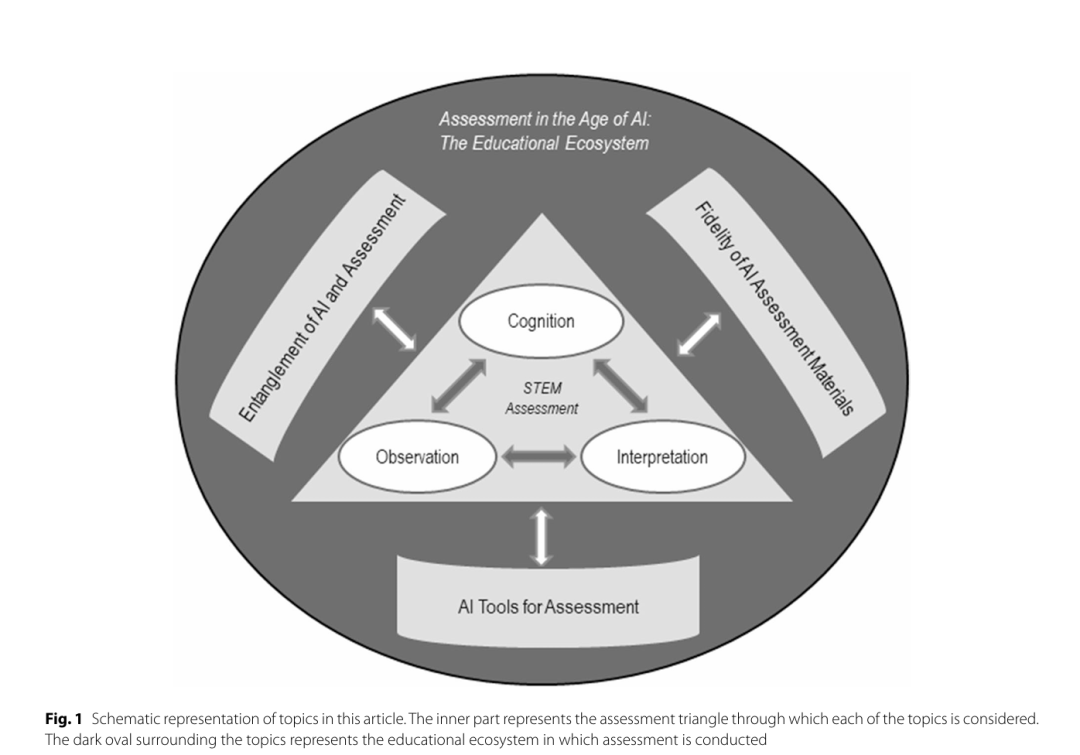
文章的核心分析框架是NRC(2001)提出的评价三角,包含三个相互关联的元素:
认知(Cognition):我们希望学生知道什么、能做什么,即学习目标;
观察(Observation):通过什么任务收集学习证据,即评价任务设计;
解释(Interpretation):如何从证据中推断学生的学习状态,即评分与推断。
有效的评价必须让这三者对齐:学习目标清晰定义,任务能引出目标学习的证据,评分方法能支持合理解释。生成式AI同时冲击了这三个顶点,以及它们之间的连接。
在此之上,文章采用生态系统视角(Bronfenbrenner, 1979; Cheville, 2019)进行综合分析。该视角将人类发展视为嵌套情境中交互作用的产物,从课堂、校外活动等直接情境,到更广泛的制度、文化和社会环境。文章认为,评价三角的三个元素本身不可分割,而生成式AI正在从根本上改变K-12和大学中完成工作的方式,因此理解AI时代的评价必须考虑这些更广泛的文化实践变迁。
研究问题与假设
核心问题:
生成式AI如何重塑STEM教育中的评价方法、实践与政策?
四个探索性假设:
①GenAI如何影响评价三角中的认知(我们评价什么)?
②ererGenAI如何影响观察(我们如何收集学习证据)?
③GenAI如何影响解释(我们如何从证据中推断学习)?
④这三个元素之间的连接在AI时代如何重新对齐?
研究假设
①生成式AI对评价的冲击应被框定为效度问题,而非单纯的作弊问题;
②AI对不同评价形式的冲击不均衡,论文、带回家考试和编程任务尤为脆弱;
③评价重心需要从"最终产品"转向"过程证据";
④AI在评价分析中最合适的角色是"人在回路中",而非完全替代人类判断;
⑤AI生成的教学材料在用于评价前,必须经过保真度评估
研究方法
文章采用范围综述方法,具体步骤如下:
(1)数据库选择
检索覆盖三个主流数据库:Scopus、Web of Science、ERIC。
(2)检索策略
使用AI相关术语与评价相关术语的组合进行检索:
AI术语:"artificial intelligence" OR "generative artificial intelligence" OR "generative AI" OR "GenAI" OR "large language model"
评价术语:"assessment design" OR "assessment redesign" OR "assessment practice" OR "assessment validity" OR "assessment integrity" OR "educational assessment" OR "exam" OR "assignment" OR "grading"
(3)分析方法
对检索到的文献进行分析,揭示生成式AI如何影响评价三角的三个元素——认知、观察和解释。分析从生态系统视角出发,整体综合相关研究发现,而非局限于单一研究或单一评价工具。
(4)综合归纳
将研究发现归纳为三个新兴主题:
①AI与评价系统的"纠缠":效度、重新设计、可接受使用政策;
②AI用于分析评价证据并提供反馈;
③AI生成评价材料的保真度评估。
03
1. AI已深度“纠缠”进评价系统,效度危机倒逼评价重新设计。
AI对不同评价形式的冲击并不均衡,国际调查显示论文、带回家考试和计算机编程受威胁最大,传统无监督写作任务尤其脆弱,因为聊天机器人可以生成连贯答案却几乎无法证明学生自己的思考。文章强调关键不是“用不用AI”,而是具体AI使用方式如何与评价工具互动,是增强了还是削弱了目标认知的证据。既然AI能生成“最终产品”,评价就必须转向过程证据,文章提出带注释的草稿、课堂检查点、决策反思记录等策略,并倡导真实性评价和口试复兴。同时,什么算“可接受的AI使用”往往取决于任务、学科、学习目标和课程规范,机构政策发展迅速且不均衡,AI检测工具不可靠还可能对某些群体产生不成比例的影响,因此文章主张政策应与积极课堂文化结合,让学生理解学习的价值,知道AI何时支持学习、何时不应使用,并把教师视为合作伙伴。
2. AI正被用于分析评价证据并提供反馈,但最强角色是“人在回路中”。
AI在STEM教育中已被用于自动评分、自适应测试、结构化反馈等,生成式AI进一步扩展了这些能力,包括分类开放题回答、评分论文和建构性回答、生成反馈,甚至支持新测量工具的开发。研究显示,AI可以分析学生用自己的语言表达的学科理解,其价值在于围绕学科思想和推理模式设计自动化分析,而非表面文本相似度,这使大规模建构性回答评价成为可能。但文章强调,AI支持的评价本质上是设计与治理问题,不是简单用技术替代人工评分。最强角色是“人在回路中”:AI快速识别模式、提供临时反馈或标记异常,教师保留构念定义、高利害决策和异常案例的最终判断权。
3. AI生成评价材料的保真度亟需评估,真实性与保真度是两个不同概念。
生成式AI越来越多地用于生成评价任务和教学材料,如课堂对话、教学案例、实验场景、模拟学生作业等,这带来一个新问题:这些AI生成的材料是否有足够保真度来激发目标认知?文章区分了两个概念:真实性指评价任务是否反映有意义的专业实践,保真度指AI生成材料是否准确、可信地模拟了它要代表的教育情境。现有研究揭示,AI生成的教育对话和模拟学生回应存在明显局限,包括互动结构简化、行为模式重复、学生错误不真实、对个体学习者回应不足。因此,AI生成评价任务必须经过人在回路中的评估和迭代优化,才能用于学习和评价。
04
生成式AI的影响远超“新工具”或“新作弊威胁”,它要求我们整体重新思考学习目标、学生表现和解释之间的对齐关系。
具体而言:
认知:不仅要评价传统学科能力,还要评价AI素养和与AI协作的判断力;
观察:需要多种证据形式,有些任务确立独立学科能力,有些评价学生使用、批判和验证AI支持工作的能力;
解释:AI可用于分析证据,但必须与人类判断互补,并接受效度验证。
文章还提出一个理论视角:STEM专业能力应被视为情境化表现,而非单纯的知识获取。生成式AI进一步把“知道”的位置从个体头脑转移到人、表征、工具和物质环境分布的活动之中。
05
(1)对教师:
①把AI使用视为效度问题,而非单纯作弊问题;
②在评价中嵌入过程证据:草稿、检查点、反思、口试;
③设计真实性任务,让学生看到学习的职业意义;
④明确任务层面的AI使用规则,并给出示例
(2)对课程设计者:
①构建组合式评价体系:无AI评价、允许指定AI支持的评价、要求学生评估或改进AI输出的评价;
②关注AI生成评价材料的保真度,建立人在回路的审核机制;
③避免把所有灵活评价都替换为高压考试。
(3)对管理者:
①认识到评价重新设计需要大量劳动,应重新协商教师职责;
②制定一致、可操作、任务层面的AI政策;
③投资积极课堂文化,而非依赖检测与监控。
06
生成式AI不会消失,它已经嵌入STEM专业实践。真正的问题不是“学生有没有用AI”,而是:
我们需要什么证据,才能合理推断学生具备了面向未来的STEM能力?AI又应该在这证据生产中扮演什么角色?
这篇文章的价值,在于它把讨论从“如何抓作弊”提升到“如何重新设计评价、重新定义能力、重新理解学习”。对于每一位关心STEM教育的人来说,这既是一次挑战,也是一次重新思考教育本质的机会。